Depuis 2023, la Responsible Scaling Policy Anthropic revue cinq
Anthropic encadre le développement de ses IA par une politique volontaire, la Responsible Scaling Policy. Voici ce qu'elle promet, ses seuils et ses limites.
Sommaire6 sections · 8 min
La Responsible Scaling Policy Anthropic (RSP) est le document qui régit, depuis septembre 2023, la façon dont l'entreprise fondée par Dario Amodei décide d'entraîner et de déployer ses modèles Claude. Il ne s'agit pas d'une loi ni d'une norme imposée par un régulateur, mais d'un engagement volontaire que l'entreprise a choisi de rendre public et de mettre à jour régulièrement, la dernière version datant du 8 juillet 2026.
Un cadre né en 2023, sans cesse révisé
Anthropic a publié la première version de sa Responsible Scaling Policy le 19 septembre 2023. Le texte fondateur posait un principe simple : l'entreprise s'engage à ne pas entraîner ni déployer de modèles capables de provoquer des dommages catastrophiques sans avoir mis en place des mesures de sécurité et de sûreté qui maintiennent les risques sous un seuil acceptable.
Depuis, le document a connu de multiples révisions. La version 2.2 est entrée en vigueur le 14 mai 2025, puis l'entreprise a procédé à une réécriture complète avec la version 3.0, effective le 24 février 2026. Selon Anthropic, cette version 3.0 introduit une distinction entre les mesures que l'entreprise s'engage à appliquer quelle que soit l'attitude du reste du secteur, et une cartographie plus ambitieuse censée guider l'ensemble de l'industrie si elle était adoptée largement.
Les versions successives de 2026
L'année 2026 a vu se succéder plusieurs révisions rapprochées : la version 3.1 le 2 avril, la version 3.2 le 29 avril, la version 3.3 le 26 mai, puis la version 3.4 le 8 juillet. Chaque mise à jour a précisé un point technique particulier. La version 3.1 a clarifié la manière d'opérationnaliser le seuil de capacité lié à la recherche et développement automatisés, ainsi que l'usage des retours internes sur les rapports de risque. La mise à jour d'août 2026 a, elle, étendu l'intervalle d'évaluation à six mois, une décision prise, selon Anthropic, pour éviter une élicitation des capacités des modèles bâclée par manque de temps.
Le principe des niveaux de sécurité IA
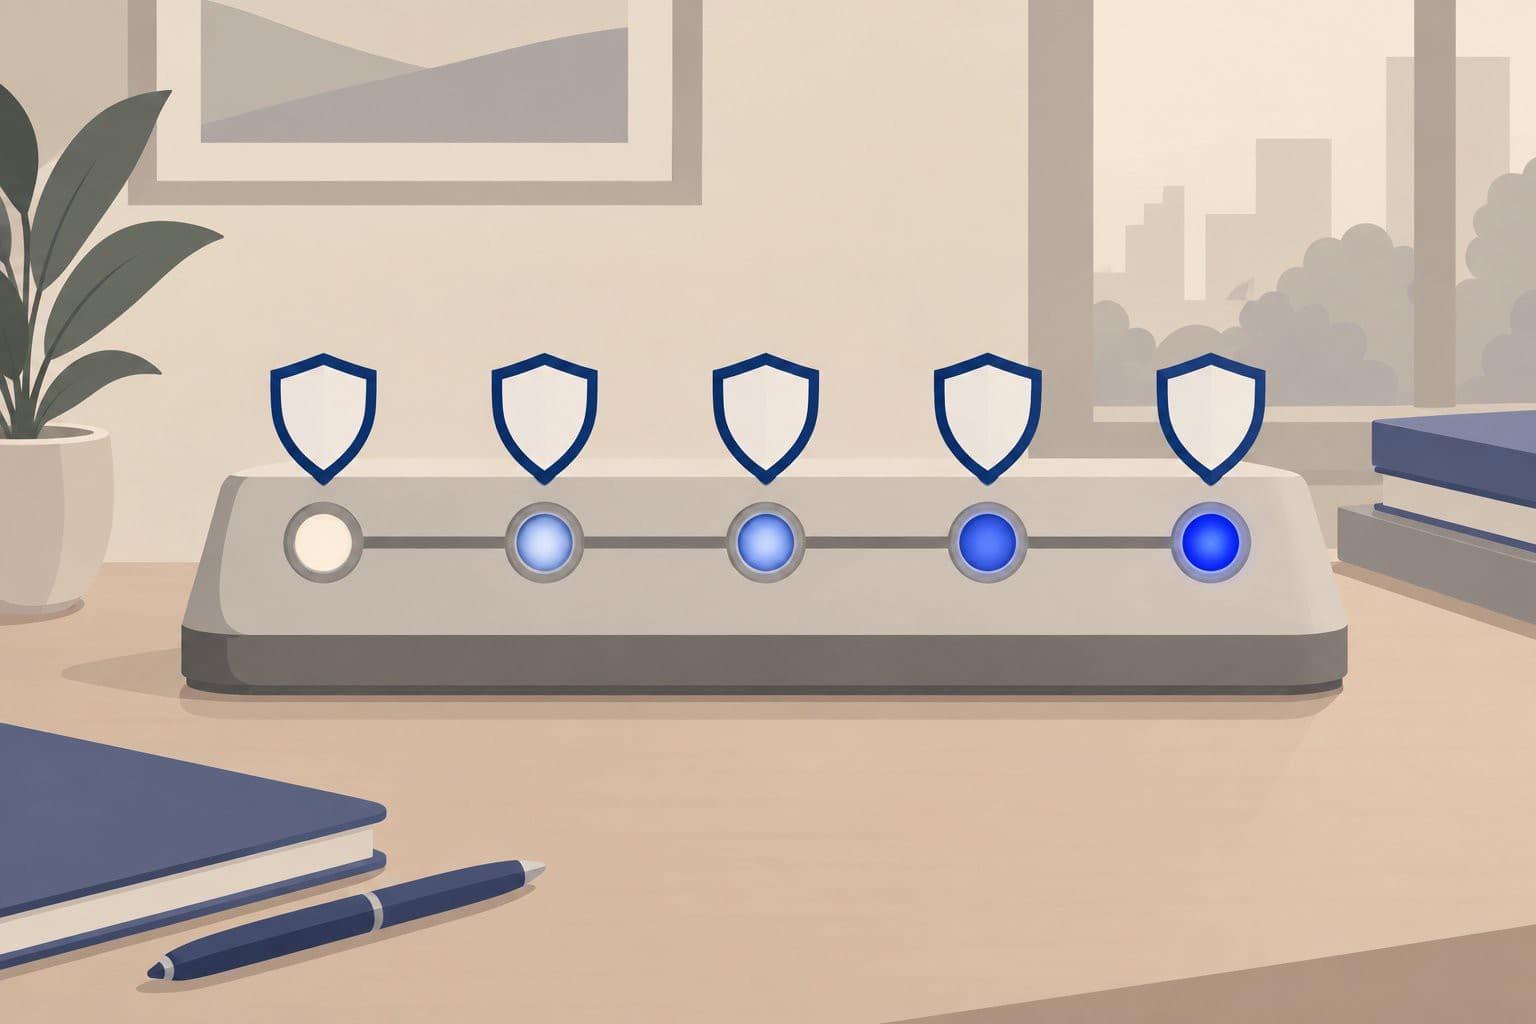
Le cœur de la politique repose sur les AI Safety Levels (ASL), un système inspiré des normes américaines de biosécurité (BSL) qui encadrent la manipulation de matières biologiques dangereuses. Plus un modèle affiche des capacités jugées risquées, plus le niveau de protection exigé grimpe. Anthropic a fixé le principe dès la version 1.0 : l'entreprise s'engage à suspendre l'entraînement ou à retarder le déploiement d'un nouveau modèle si sa capacité dépasse ce que les procédures de sécurité en vigueur permettent de couvrir.
Comment fonctionnent les seuils de capacité
La version d'octobre 2024 a introduit la notion de seuils de capacité (Capability Thresholds) associés à des garde-fous requis (Required Safeguards). Deux seuils structurent aujourd'hui la politique.
Le premier concerne la recherche et le développement autonomes en intelligence artificielle : si un modèle peut mener seul des tâches de recherche complexes normalement réservées à des experts humains, au point de pouvoir accélérer le développement de l'IA de façon imprévisible, Anthropic dit exiger des standards de sécurité renforcés, potentiellement de niveau ASL-4 ou supérieur. La version 3.0 a d'ailleurs remplacé plusieurs seuils par un seul, formulé ainsi selon l'analyse publiée par Governance.ai : un modèle capable de « compresser deux années de progrès de l'IA entre 2018 et 2024 en une seule année ».
Le second seuil porte sur les armes chimiques, biologiques, radiologiques et nucléaires (CBRN). Si un modèle peut aider de façon significative une personne ayant des connaissances techniques de base à concevoir ou déployer ce type d'arme, la politique impose le passage aux standards ASL-3.
Les niveaux ASL en détail
Chaque niveau correspond à un jeu de mesures précises, de l'accès aux poids du modèle jusqu'aux conditions de déploiement commercial.
| Niveau | Type de modèle concerné | Exigences principales |
|---|---|---|
| ASL-1 | Systèmes sans capacité autonome significative (chatbots basiques, IA qui joue aux échecs) | Pas de mesure spécifique |
| ASL-2 | Modèles de pointe actuels, dont Claude, qui n'accélèrent pas les risques catastrophiques au-delà de ce qu'un humain peut déjà faire | Standards correspondant aux meilleures pratiques du secteur |
| ASL-3 | Modèles pouvant accélérer significativement des risques catastrophiques, y compris via une aide sur les armes CBRN | Cybersécurité renforcée, restrictions de déploiement, rétention des entrées et sorties pendant au moins 30 jours |
| ASL-4 et au-delà | Modèles qui pourraient dépasser les capacités d'experts humains dans des domaines critiques, y compris la R&D en IA | Mesures de confinement supplémentaires, définition d'un nouveau seuil avant de poursuivre l'entraînement |
Les mécanismes d'évaluation et d'alerte
La version 1.0 avait fixé des règles de calendrier précises pour tester les modèles pendant l'entraînement : une évaluation après chaque saut de 4x en calcul effectif, et une autre tous les trois mois pour surveiller les progrès liés au fine-tuning ou aux outils. Anthropic avait aussi fixé une marge de sécurité, appelée « safety buffer », de 6x, volontairement plus large que l'intervalle d'évaluation de 4x, afin que l'entraînement puisse se poursuivre sans risque pendant que les tests ont lieu.
Pour évaluer si un modèle franchit un seuil dangereux, Anthropic dit utiliser un budget d'inférence maximal d'environ 1000 dollars par tentative de tâche, un montant fixé pour correspondre à peu près à ce qu'un expert humain accomplirait en huit heures de travail, selon le texte de la version 1.0 de la politique.
Les engagements concrets pris par Anthropic
Dès novembre 2023, dans un billet de réflexion sur sa propre politique, Anthropic avait résumé son approche en cinq engagements de haut niveau, qui restent la colonne vertébrale du dispositif :
- Établir des « capacités limites » (Red Line Capabilities), c'est-à-dire des aptitudes qui, si elles apparaissaient dans de futurs modèles, présenteraient trop de risques dans les conditions de sécurité actuelles.
- Tester ces capacités limites au moyen d'évaluations de risque frontière, conçues avec des experts du domaine.
- Répondre à l'apparition de ces capacités en développant un nouveau standard de sécurité, appelé ASL-3, avec un engagement à suspendre l'entraînement ou le déploiement si ce standard n'est pas encore applicable.
- Étendre la politique de façon itérative, en publiant à l'avance la description d'un nouveau jeu de capacités limites correspondant au niveau ASL-4.
- Mettre en place des mécanismes d'assurance, incluant la supervision du conseil d'administration et du Long-Term Benefit Trust, l'organe fiduciaire censé veiller à la mission de long terme d'Anthropic.
Le rôle du Responsible Scaling Officer
Anthropic a créé un poste dédié, celui de Responsible Scaling Officer, chargé de veiller à ce que les engagements de la politique soient réellement exécutés. Sam McCandlish, cofondateur et directeur technique, a occupé cette fonction pendant sa première année d'existence, avant d'être remplacé par Jared Kaplan, cofondateur et directeur scientifique de l'entreprise, selon l'annonce d'octobre 2024.
Les rapports de risque publics
La version 3.0 a introduit une nouvelle obligation : la publication de Risk Reports, des rapports destinés à décrire de façon directe et candide comment Anthropic perçoit les risques de ses systèmes et son état de préparation face à eux. Ces rapports doivent paraître en ligne, avec certaines rédactions, tous les trois à six mois. Le rapport d'août 2026 couvre ainsi la période allant du précédent rapport de février 2026 jusqu'au 15 juillet 2026, et détaille les mesures d'atténuation mises en œuvre ainsi que les plans à venir dans chaque catégorie de risque. Ces rapports doivent couvrir tous les modèles déployés publiquement, ainsi que les modèles déployés en interne quand Anthropic estime qu'ils pourraient poser des risques significatifs supérieurs à ceux de ses modèles publics, selon l'analyse publiée par Governance.ai.
Les quatre couches de protection annoncées en 2026
La mise à jour d'août 2026 détaille un nouveau dispositif de sécurité à quatre couches, pensé pour filtrer les usages dangereux en temps réel :
- Des contrôles d'accès qui adaptent les garde-fous au contexte de déploiement et au type d'utilisateurs attendus.
- Des classificateurs en temps réel sur les prompts et les réponses, capables de bloquer immédiatement certains contenus en ligne.
- Des classificateurs de surveillance asynchrone, qui effectuent une analyse plus détaillée des réponses pour détecter des menaces.
- Une détection a posteriori des tentatives de contournement (jailbreak), avec des procédures de réponse rapide.
Ce même texte d'août 2026 a aussi clarifié la définition jugée ambiguë de l'intervalle d'évaluation et l'a porté à six mois, pour éviter une élicitation des capacités de mauvaise qualité, faite dans la précipitation.
Ce que la politique ne garantit pas
Plusieurs limites méritent d'être posées clairement pour comprendre la portée réelle de la Responsible Scaling Policy Anthropic.
- Il s'agit d'un engagement volontaire, sans force de loi : aucune autorité extérieure ne peut sanctionner Anthropic en cas de manquement, seule la réputation de l'entreprise est en jeu.
- La politique peut être modifiée par Anthropic elle-même, sous réserve d'approbation du conseil d'administration après consultation du Long-Term Benefit Trust, ce qui laisse à l'entreprise une marge d'appréciation sur ses propres seuils.
- Les évaluations de capacités reposent sur des méthodes internes, même si Anthropic dit vouloir recourir à une validation par des tiers pour les évaluations de sécurité critiques.
- Les rapports de risque publiés peuvent comporter des rédactions, c'est-à-dire des passages retirés avant publication.
- Le périmètre des risques couverts reste centré sur des scénarios précis : armes chimiques, biologiques, radiologiques et nucléaires, recherche et développement autonomes en IA, et systèmes désalignés dans des contextes à forts enjeux, selon le Transparency Hub d'Anthropic mis à jour le 23 juillet 2026.
Questions frequentes
Qu'est-ce que la Responsible Scaling Policy d'Anthropic ?
C'est un cadre volontaire publié pour la première fois le 19 septembre 2023, qui décrit comment Anthropic identifie, évalue et atténue les risques catastrophiques posés par ses modèles d'IA, et dans quelles conditions l'entreprise s'engage à suspendre l'entraînement ou le déploiement d'un modèle.
Que signifient les niveaux ASL-1 à ASL-4 ?
Ce sont des paliers de sécurité inspirés des niveaux de biosécurité américains. ASL-1 couvre les systèmes sans capacité autonome, ASL-2 les modèles actuels comme Claude, ASL-3 les modèles pouvant significativement aider à créer des armes CBRN ou accélérer des risques, et ASL-4 les systèmes qui pourraient dépasser les capacités d'experts humains dans des domaines critiques.
La politique a-t-elle une valeur juridique contraignante ?
Non. Il s'agit d'un engagement volontaire d'Anthropic envers elle-même, sans sanction légale externe en cas de non-respect. Sa mise en œuvre repose sur la supervision interne du conseil d'administration et du Long-Term Benefit Trust.
Quelles sont les dernières mises à jour de 2026 ?
Quatre versions se sont succédé en 2026 : la version 3.0 le 24 février, la version 3.1 le 2 avril, la version 3.2 le 29 avril, la version 3.3 le 26 mai et la version 3.4 le 8 juillet. La mise à jour d'août 2026 a par ailleurs étendu l'intervalle d'évaluation des modèles à six mois et détaillé un dispositif de sécurité à quatre couches.
Quels risques la politique couvre-t-elle précisément ?
Selon le Transparency Hub d'Anthropic, les seuils actuels portent sur la production d'armes chimiques et biologiques, les systèmes d'IA désalignés placés dans des contextes à forts enjeux, et la recherche et développement automatisés dans des domaines clés comme le développement de l'IA elle-même.
Sources
- Anthropic's Responsible Scaling Policy (page officielle, mise à jour août 2026)
- Introducing Anthropic's Responsible Scaling Policy
- Announcing our updated Responsible Scaling Policy
- Responsible Scaling Policy Version 3.0
- Anthropic's Responsible Scaling Policy (version 3.0, PDF)
- Anthropic's Responsible Scaling Policy (version 3.1, PDF)
- Anthropic's RSP v3.0: How it Works, What's Changed, and Some Reflections
- Anthropic's Transparency Hub
- Reflections on our Responsible Scaling Policy
- Anthropic's Responsible Scaling Policy, Version 1.0 (PDF)
- Anthropic's Responsible Scaling Policy (version 2.2, PDF)
- Anthropic Responsible Scaling Policy - VerifyWise AI Governance Library
Sujets
- anthropic64
- intelligence artificielle191
- responsible scaling policy
- sécurité de l'ia7
- claude22
- gouvernance ia3
Sur le même sujet
 IaPourquoi l'interprétabilité mécanistique Anthropic ouvre ClaudeAnthropic construit des outils pour lire l'intérieur de Claude plutôt que d'observer ses seules réponses.
 IaSans annotateurs humains : le pari du Constitutional AI AnthropicComment Anthropic entraîne Claude à se corriger lui-même grâce à des principes écrits plutôt qu'à des humains. Un guide complet, dates et chiffres à l'appui.
 IaIA : pourquoi Anthropic et OpenAI ne voient pas les risquesAnthropic et OpenAI défendent deux visions opposées de la sécurité de l'intelligence artificielle.